Który model system one z rodziny basal zmieści się na karcie graficznej z 16 GB VRAM?
Dzisiaj na warsztat idzie rodzina modeli basal: basal-2.0, basal-omni-1.0 oraz basal-omni-pico. Skupiam się na wersjach GGUF uruchamianych na llama.cpp server w kontenerze docker, a natywną ścieżkę (transformers) dokładam tylko jako punkt odniesienia.
basal to otwarte (Apache-2.0) modele decyzyjne (System One) dla języka polskiego i angielskiego, projekt Remigiusza Kinasa. Model dostaje stan (tekst) oraz pytania z dozwolonymi odpowiedziami i zwraca ich prawdopodobieństwa, więc klasyfikator definiujesz w każdym zapytaniu, bez trenowania. Modele obsługuje basal-serve, który liczy albo na własnym backendzie, albo - jak tutaj - przez osobny serwer llama.cpp (--mode llamacpp). W dalszej części “System 2” oznacza zwykły, generatywny LLM, który obok szybkiej warstwy decyzyjnej może działać na tej samej karcie.
Czego tu nie ma: porównania z modelami spoza rodziny basal ani ocen jakości poza wbudowanym benchmarkiem. Największy praktyczny zysk nie wyszedł z wyboru modelu, tylko z jednej flagi basal-serve (--http-parallel, do 2x przepustowości) - szczegóły w sekcji o teście obciążeniowym.
Accuracy w tym artykule pochodzi z benchmarka uruchamianego w tym stacku. To nie jest Werdykt (5 000 decyzji PL+EN), którym projekt basal opisuje modele na swoim blogu, więc liczb z obu źródeł nie porównuj.
Technikalia
Środowisko testowe
- GPU: RTX 4070 Ti SUPER, 16376 MiB, sterownik 580.178.04
- Docker Engine 29.9.2
- llama.cpp:
ghcr.io/ggml-org/llama.cpp:server-cuda, buildb11681(commit5e03a1ff) - pakiet basal w obrazie docker: v2.3.1, w trakcie testu zaktualizowany do v2.3.3 (kolumna
pkgw tabelach). Wierszeomni-picopowstały dopiero na v2.3.3, bo według wpisu o wydaniu 2.3.2 dopiero ta wersja poprawnie obsługuje architekturę pico (Qwen3.5 z warstwami Gated DeltaNet) - pakiet basal natywny: v2.4.1 (projekt wydaje nowe wersje niemal codziennie)
Stack to dwa kontenery: llama-server (backend) i basal-serve (HTTP front, który renderuje i parsuje zapytania i woła backend).
# Dockerfile
ARG BASE_IMAGE=python:3.14-slim
FROM ${BASE_IMAGE}

ARG BASAL_REF=v2.3.3

ENV PIP_NO_CACHE_DIR=1 \
    PYTHONUNBUFFERED=1 \
    HF_HOME=/cache/huggingface

RUN pip install --extra-index-url https://download.pytorch.org/whl/cpu torch \
    && pip install "basal @ https://github.com/rkinas/basal/archive/refs/tags/${BASAL_REF}.tar.gz"

EXPOSE 8000
Poniżej przykładowe Docker Compose w wersji odpowiadającej konfiguracji (2.0-mini Q8_0, np 8, --http-parallel 32); pozostałe punkty pomiarowe to zmiana -m, -np, -c i --http-parallel.
# docker-compose.yml
name: basal-bench

services:
  basal-llm:
    image: ghcr.io/ggml-org/llama.cpp:server-cuda
    runtime: nvidia
    environment:
      NVIDIA_VISIBLE_DEVICES: all
      NVIDIA_DRIVER_CAPABILITIES: compute,utility
    command: >-
      -m /models/basal-2.0-mini-Q8_0.gguf
      --alias basal-2.0-mini-Q8_0
      -c 65536
      -np 8
      -ngl 99
      -ctk q8_0
      -ctv q8_0
      --host 0.0.0.0
      --port 8080
    volumes:
      - /path/to/models:/models:ro
    ports:
      - "127.0.0.1:${BASAL_BENCH_LLM_PORT:-8084}:8080"
    healthcheck:
      test: ["CMD-SHELL", "curl -sf http://127.0.0.1:8080/health || exit 1"]
      interval: 10s
      timeout: 5s
      retries: 30
      start_period: 30s

  basal-serve:
    image: basal-serve
    environment:
      HF_HOME: /cache/huggingface
    command: >-
      basal-serve
      --model Remek/basal-2.0-mini-GGUF
      --http-parallel 32
      --mode llamacpp
      --llamacpp-url http://basal-llm:8080
      --host 0.0.0.0
      --port 8000
    volumes:
      - basal_hf_cache:/cache/huggingface
    ports:
      - "127.0.0.1:${BASAL_BENCH_SERVE_PORT:-8005}:8000"
    depends_on:
      basal-llm:
        condition: service_healthy

volumes:
  basal_hf_cache:
Warianty KV cache to wyłącznie flagi backendu llama.cpp:
# f16: bez flag
# q8_0:
-ctk q8_0 -ctv q8_0
# q4_0:
-ctk q4_0 -ctv q4_0
Dwie rzeczy z compose’a, które zmieniają odczyt wyników:
- llama.cpp
-c= 8192 x-np(tu 65536 = 8192 x 8) --http-paralleljest flagąbasal-serve, nie llama.cpp. Przy domyślnym1backend z ośmioma slotami widzi jedno zapytanie naraz (tutaj32).
W tabelach poniżej VRAM to wartość procesu llama-server z nvidia-smi (compute-apps), w MiB, nie całkowite zużycie karty. W prozie przeliczam na GiB.
Wariant CPU-only: ten sam build CPU llama.cpp bez runtime GPU, AMD Ryzen 5 5600X (6 rdzeni, 12 wątków, do 4.65 GHz), 32 GB RAM, domyślna liczba wątków (12, bez -t).
Modele basal
Rozmiary plików z ls -h, czyli w GiB/MiB:
| model | kwantyzacje wag w teście | rozmiar pliku GGUF | rozmiar pliku safetensors |
|---|---|---|---|
basal-2.0-mini |
Q5_K_M, Q8_0 | 1,1 / 1,6 GiB | 3,2 GiB |
basal-2.0-4.5B |
Q5_K_M, Q8_0 | 3,2 / 4,8 GiB | 9,5 GiB |
basal-2.0-max |
Q8_0 | 12 GiB | 22,3 GiB |
basal-omni-pico |
Q8_0 | 775 MiB | 1,5 GiB |
basal-omni-1.0-mini |
Q6_K, Q8_0 | 5,8 / 7,5 GiB | 15,9 GiB |
basal-omni-1.0-max |
Q8_0 | 12 GiB | 23,9 GiB |
basal-omni-1.0-ultra |
nie testowany | – | 62,5 GiB |
Model basal-omni-1.0-ultra jest zbyt duży, abym go mógł przetestować.
Modele omni (bazujące na Gemma 4) obsługują dodatkowo obraz i dźwięk. Ten test sprawdza tylko ścieżkę tekstową.
Sposób testowania
Plan
- Test w trybie natywnym.
- Test z użyciem modeli GGUF.
Narzędzia
Używam tylko narzędzi i danych testowych dostarczonych przez pakiet Python basal.
Benchmark basal-bench – Każda konfiguracja leci dwa razy (wcześniej wykonywałem więcej powtórzeń i wyniki były powtarzalne). Metryki: lat1 (opóźnienie jednego przejścia), lat2 (batch dwóch “orderów” w terminologii benchu) wraz z p95, dec/s (decyzje na sekundę, tak jak je liczy bench) oraz accuracy. Accuracy jest identyczne między dwoma przebiegami każdej konfiguracji, więc dwa przebiegi służą tylko do uśrednienia opóźnień.
Test obciążeniowy HTTP basal-loadtest – 32 klientów, krótkie prompty, wagi Q8_0, KV q8_0, basal v2.3.3, jeden przebieg na konfigurację. Kontekst skaluje się ze slotami: -c = 8192 x np, więc każdy slot ma okno 8192 tokenów.
Trzy zastrzeżenia, zanim przejdziemy do liczb:
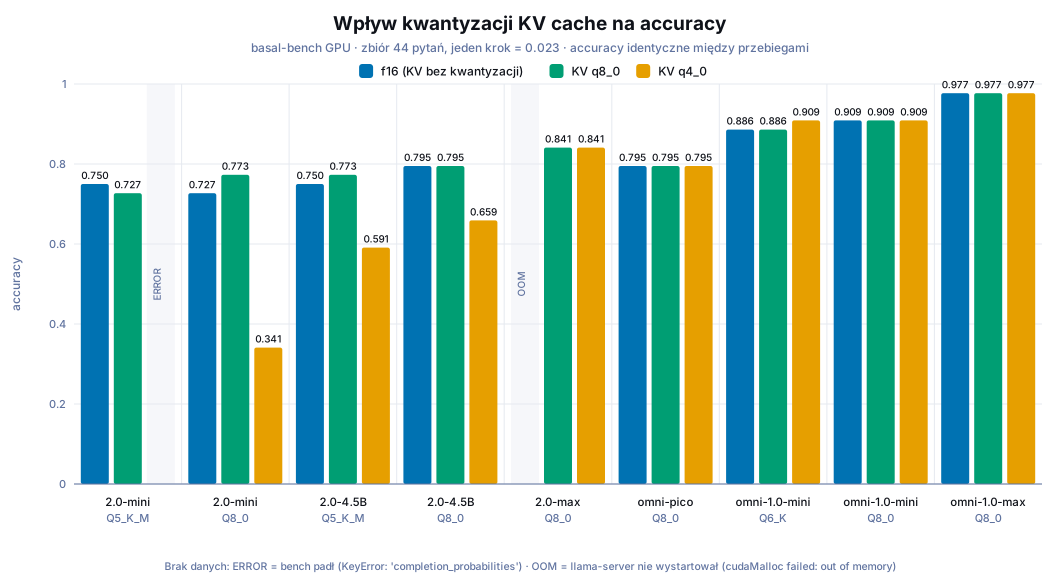
- Bench ma 44 wbudowane elementy, więc wszystkie wartości accuracy są wielokrotnościami 1/44 (
0.795= 35/44,0.773= 34/44,0.977= 43/44), a jedno pytanie to0.023. Różnice rzędu0.02-0.05to jedna-dwie odpowiedzi. - Testy obciążeniowe po HTTP to pojedyncze przebiegi. Różnice kilku procent traktuję jako szum. Dwa niezależne pomiary tej samej konfiguracji (mini Q8_0,
np 2,--http-parallel 1) dały 127.4 i 127.0 dec/s, a pico 52.8 i 53.2 dec/s, więc dec/s jest stabilne w granicach 1%. P95 szumi bardziej (pico: 42.3 vs 38.1 ms). - Ścieżka natywna działa na pakiecie v2.4.1, a GGUF na v2.3.x, więc porównanie tych dwóch ścieżek miesza też wersje silnika.
Wyniki
Natywny basal-bench (transformers, bez llama.cpp)
basal-bench uruchomiony bezpośrednio na wagach z Hugging Face w safetensors (ścieżka referencyjna transformers), z domyślnymi trybami i na 44 wbudowanych pytaniach. Natywnie mierzyłem tylko mini i pico.
| model | mode | lat2 [ms] | lat1 [ms] | dec/s | agree | acc | pamięć torch [GB] |
|---|---|---|---|---|---|---|---|
| 2.0-mini | eager-fp32 | 52.9 | 35.8 | 19.1 | – | 0.750 | 8.1 |
| 2.0-mini | fast | 17.0 | 10.1 | 71.8 | 0.977 | 0.727 | 4.3 |
| omni-pico | eager-fp32 | 38.0 | 36.0 | 32.0 | – | 0.795 | 6.4 |
| omni-pico | eager | 40.4 | 39.2 | 49.4 | 1.000 | 0.795 | 4.6 |
Ostatnia kolumna pochodzi z wyjścia benchu (pamięć na karcie raportowana po stronie torch), więc nie porównuję jej wprost z VRAM z nvidia-smi w tabelach llama.cpp poniżej, ale daje obraz zapotrzebowania na pamięć.
Spostrzeżenia:
- Tryb
fastjest ok. 3.1x szybszy odeager-fp32na mini (lat217.0 vs 52.9 ms), przy zgodności decyzji 97.7% i accuracy 0.727 zamiast 0.750 — jedno pytanie z 44. - Pico nie ma trybu
fast— domyślna para toeager-fp32+eager. Zgodność 1.000, accuracy identyczne (0.795). Bench zgłasza dwa ostrzeżenia transformers: brak kernelicausal_conv1diflash-linear-attention, więc referencyjny fallback PyTorcha leciał wolniej niż byłoby zoptymalizowane. - omni-1.0-mini nie wstaje natywnie: 15,9 GiB safetensors nie mieści się na karcie 16 GB (15,99 GiB) razem z kontekstem CUDA i aktywacjami, więc nie ma pomiaru (oba formaty w tabeli w sekcji Modele). Zmierzone natywnie modele mają 1,5-3,2 GiB wag safetensors.
dec/sz benchu nie wynika wprost zlat2. Natywne picoeagerma gorszelat1/lat2niżeager-fp32(39.2/40.4 vs 36.0/38.0 ms), a lepszedec/s(49.4 vs 32.0). Dlatego porównujędec/stylko w obrębie tego samego benchu.
basal-bench GPU-only llama.cpp
Parametry llama.cpp: -np 2, -c 16384, -ngl 99, a basal-serve uruchomiony z --http-parallel 1.
| model | wagi | pkg | KV | lat1 [ms] | lat2 [ms] | p95 [ms] | dec/s | accuracy | VRAM [MiB] |
|---|---|---|---|---|---|---|---|---|---|
| 2.0-mini | Q5_K_M | 2.3.1 | f16 | 9.7 | 12.7 | 14.8 | 52.8 | 0.750 | 1898 |
| 2.0-mini | Q5_K_M | 2.3.1 | q8_0 | 10.3 | 13.6 | 15.0 | 49.7 | 0.727 | 1660 |
| 2.0-mini | Q5_K_M | 2.3.1 | q4_0 | ERROR | bench ERROR | ||||
| 2.0-mini | Q8_0 | 2.3.1 | f16 | 10.3 | 14.0 | 15.0 | 48.6 | 0.727 | 2404 |
| 2.0-mini | Q8_0 | 2.3.1 | q8_0 | 11.6 | 15.5 | 16.8 | 45.2 | 0.773 | 2166 |
| 2.0-mini | Q8_0 | 2.3.1 | q4_0 | 11.2 | 15.2 | 16.4 | 46.9 | 0.341 | 2038 |
| 2.0-4.5B | Q5_K_M | 2.3.1 | f16 | 20.1 | 26.1 | 28.7 | 24.9 | 0.750 | 4502 |
| 2.0-4.5B | Q5_K_M | 2.3.1 | q8_0 | 21.8 | 28.3 | 31.3 | 23.7 | 0.773 | 4056 |
| 2.0-4.5B | Q5_K_M | 2.3.1 | q4_0 | 21.7 | 28.0 | 30.7 | 24.3 | 0.591 | 3816 |
| 2.0-4.5B | Q8_0 | 2.3.1 | f16 | 22.1 | 30.9 | 33.2 | 22.7 | 0.795 | 6066 |
| 2.0-4.5B | Q8_0 | 2.3.1 | q8_0 | 23.9 | 33.1 | 35.9 | 21.6 | 0.795 | 5620 |
| 2.0-4.5B | Q8_0 | 2.3.1 | q4_0 | 23.7 | 32.8 | 35.0 | 22.2 | 0.659 | 5380 |
| 2.0-max | Q8_0 | 2.3.1 | f16 | OOM | OOM przy starcie | ||||
| 2.0-max | Q8_0 | 2.3.1 | q8_0 | 33.6 | 53.9 | 57.7 | 14.4 | 0.841 | 13266 |
| 2.0-max | Q8_0 | 2.3.1 | q4_0 | 33.2 | 53.7 | 56.6 | 14.8 | 0.841 | 12466 |
| omni-pico | Q8_0 | 2.3.3 | f16 | 14.3 | 23.8 | 25.3 | 24.8 | 0.795 | 1294 |
| omni-pico | Q8_0 | 2.3.3 | q8_0 | 14.5 | 24.1 | 26.2 | 24.8 | 0.795 | 1230 |
| omni-pico | Q8_0 | 2.3.3 | q4_0 | 14.6 | 24.2 | 25.3 | 24.8 | 0.795 | 1182 |
| omni-1.0-mini | Q6_K | 2.3.3 | f16 | 39.1 | 57.4 | 64.1 | 12.5 | 0.886 | 4426 |
| omni-1.0-mini | Q6_K | 2.3.3 | q8_0 | 40.7 | 59.4 | 66.6 | 12.1 | 0.886 | 4282 |
| omni-1.0-mini | Q6_K | 2.3.3 | q4_0 | 40.5 | 59.1 | 65.8 | 12.3 | 0.909 | 4198 |
| omni-1.0-mini | Q8_0 | 2.3.1 | f16 | 38.0 | 60.0 | 66.3 | 12.7 | 0.909 | 5448 |
| omni-1.0-mini | Q8_0 | 2.3.1 | q8_0 | 40.0 | 62.3 | 67.8 | 12.3 | 0.909 | 5304 |
| omni-1.0-mini | Q8_0 | 2.3.1 | q4_0 | 39.7 | 61.4 | 66.7 | 12.5 | 0.909 | 5220 |
| omni-1.0-max | Q8_0 | 2.3.1 | f16 | 72.6 | 149.7 | 184.6 | 5.1 | 0.977 | 13676 |
| omni-1.0-max | Q8_0 | 2.3.1 | q8_0 | 72.9 | 127.2 | 143.8 | 6.3 | 0.977 | 13114 |
| omni-1.0-max | Q8_0 | 2.3.1 | q4_0 | 71.8 | 122.7 | 137.7 | 6.6 | 0.977 | 12810 |
Najlepsze accuracy na model:
- 2.0-mini
0.773(Q8_0, q8_0 KV) - 2.0-4.5B
0.795(Q8_0), - 2.0-max
0.841, - omni-pico
0.795, - omni-1.0-mini
0.909, - omni-1.0-max
0.977.
Rzeczy, które widać w tabeli:
- KV q4_0 psuje modele 2.0 małe i średnie, ale nie max. 4.5B spada do 0.591/0.659 (Q5_K_M/Q8_0), mini Q8_0 do 0.341. Tymczasem 2.0-max na q4_0 trzyma 0.841, a modele omni nie ruszają się wcale (pico 0.795, omni-mini Q8_0 0.909, omni-max 0.977 na wszystkich trzech wariantach). Wyjątek to omni-mini Q6_K, gdzie accuracy zależy od cache (f16 0.886, q8_0 0.886, q4_0 0.909), czego na Q8_0 nie ma. Przy skali 1/44 to jedno pytanie, ale kierunek jest odwrotny do oczekiwanego (q4_0 najlepsze), więc ufałbym temu tylko jako dowodowi, że Q6_K jest czułe na konfigurację.
- Kwantyzacja KV głównie oszczędza VRAM, a nie przyspiesza.
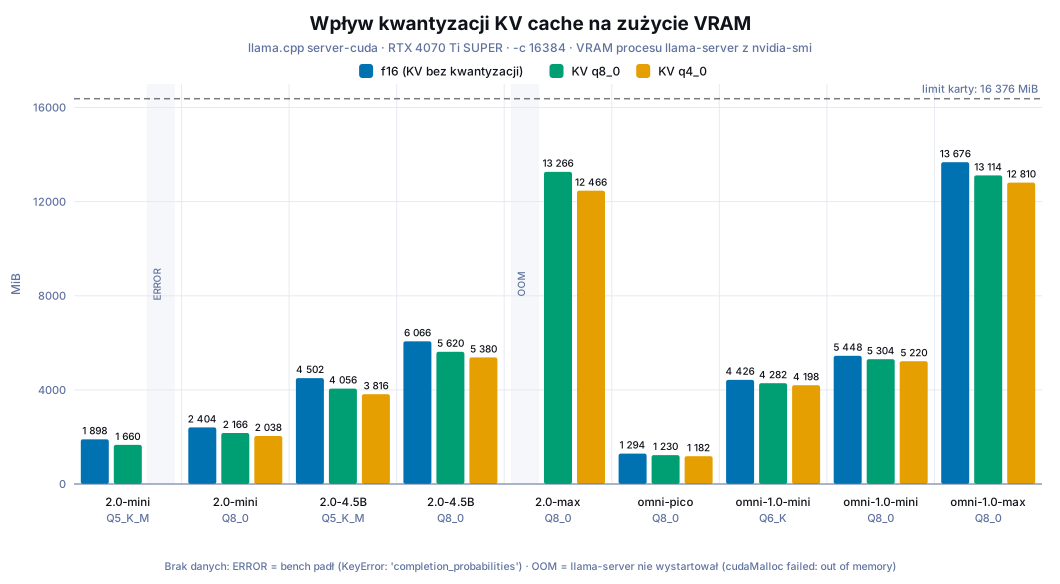
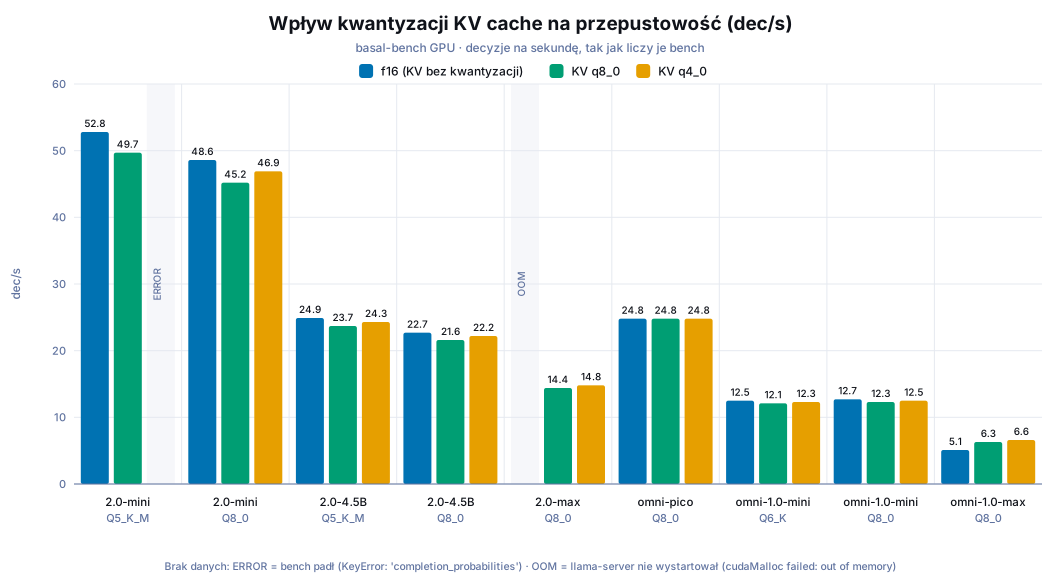
Na małych modelach lat2 rośnie przy przejściu z f16 na q8_0 (4.5B Q8_0: 30.9 -> 33.1 ms, mini Q8_0: 14.0 -> 15.5 ms, omni-mini Q8_0: 60.0 -> 62.3 ms). Oszczędność VRAM przy
-c 16384to 64-562 MiB (pico 64, omni-mini 144, mini 238, 4.5B 446, omni-max 562). Przy modelach 1-6 GiB nie ma to znaczenia, przy 13 GiB ma. Oszczędność rośnie liniowo z-c, więc w konfiguracjach znp 8(-c 65536) jest 4x większa. Wyjątek: omni-1.0-max na f16 traci na batchu.lat1zostaje przy ok. 73 ms, alelat2skacze do 149.7 ms, a p95 do 184.6 ms (q8_0: 127.2 i 143.8 ms,dec/s5.1 -> 6.3). Mechanizmu nie badałem, wiem tylko, że to wynik powtarzalny w obu przebiegach. 2.0-max na f16 nie wstaje:cudaMalloc failed: out of memory. Z delt VRAM między wariantami KV wychodzi mi, że f16 potrzebowałby ok. 14 770 MiB (14,4 GiB; to moja ekstrapolacja, nie pomiar), a karta 16 GB VRAM musi jeszcze u mnie utrzymać aplikacje desktopowe. Wiersz oznaczony jako OOM.mini Q5_K_Mz q4_0 wywala bench błędemKeyError: 'completion_probabilities', za każdym razem (sprawdzałem kilka razy). Nie wiem, czy to bug benchu, czy ta sama degradacja KV q4_0, która obniża mini Q8_0 do 0.341; nie badałem tego.
Q6_K vs Q8_0 w omni-1.0-mini
Q6_K oszczędza dokładnie 1022 MiB (ok. 1,0 GiB) VRAM na każdym wariancie KV (4426/4198/4282 vs 5448/5220/5304 MiB) i jest przy tym odrobinę szybszy: lat2 57.4-59.4 ms vs 60.0-63.1 ms (63.1 ms to wynik Q8_0 na v2.3.3, patrz re-test poniżej). Accuracy 0.886-0.909 vs 0.909.
Re-test na v2.3.3
Konfiguracje z KV q8_0 powtórzone po aktualizacji pakietu (2 przebiegi każda):
| model | wagi | pkg | lat1 [ms] | lat2 [ms] | p95 [ms] | dec/s | accuracy | VRAM [MiB] |
|---|---|---|---|---|---|---|---|---|
| 2.0-mini | Q5_K_M | 2.3.3 | 10.6 | 13.7 | 15.0 | 49.5 | 0.727 | 1660 |
| 2.0-mini | Q8_0 | 2.3.3 | 11.3 | 15.3 | 16.5 | 45.8 | 0.773 | 2166 |
| 2.0-4.5B | Q5_K_M | 2.3.3 | 22.0 | 28.2 | 30.7 | 23.6 | 0.773 | 4056 |
| 2.0-4.5B | Q8_0 | 2.3.3 | 25.0 | 34.0 | 36.6 | 21.3 | 0.795 | 5620 |
| 2.0-max | Q8_0 | 2.3.3 | 33.6 | 54.2 | 57.3 | 14.4 | 0.841 | 13266 |
| omni-1.0-mini | Q8_0 | 2.3.3 | 40.6 | 63.1 | 69.5 | 12.2 | 0.909 | 5304 |
| omni-1.0-max | Q8_0 | 2.3.3 | 72.7 | 126.7 | 142.9 | 6.3 | 0.977 | 13114 |
Accuracy i VRAM identyczne z v2.3.1. Największe różnice opóźnień to 1.1 ms w lat1 (4.5B Q8_0), 0.9 ms w lat2 (to samo) i 1.7 ms w p95 (omni-mini Q8_0). Aktualizacja niczego mierzalnego nie zmienia w naszym teście.
basal-bench CPU-only llama.cpp
Ryzen 5 5600X, KV q8_0, pakiet 2.3.3, 2 przebiegi.
| model | wagi | lat1 [ms] | lat2 [ms] | p95 [ms] | dec/s | accuracy |
|---|---|---|---|---|---|---|
| omni-pico | Q8_0 | 345.5 | 373.3 | 506.0 | 1.4 | 0.795 |
| 2.0-mini | Q5_K_M | 250.7 | 278.3 | 416.7 | 1.8 | 0.773 |
| 2.0-mini | Q8_0 | 220.7 | 265.9 | 405.8 | 1.9 | 0.795 |
lat1 ląduje w przedziale 220-346 ms, czyli ok. 19-24x wolniej niż ścieżka CUDA. dec/s jest 18-28x niższe. Większych modeli na CPU nie mierzyłem.
Accuracy na CPU nie jest dokładnie takie jak na GPU: mini Q8_0 dostaje 0.795 zamiast 0.773, mini Q5_K_M 0.773 zamiast 0.727.
basal-loadtest po HTTP
Test obciążeniowy: 32 klientów, krótkie prompty, wagi Q8_0, KV q8_0, v2.3.3, 1 przebieg. Domyślne ustawienia basal-serve (--http-parallel 1).
| model | wagi | p50 [ms] | p95 [ms] | dec/s | błędy | VRAM [MiB] |
|---|---|---|---|---|---|---|
| 2.0-mini | Q8_0 | 9.3 | 16.0 | 127.4 | 0 | 2166 |
| 2.0-4.5B | Q8_0 | 18.1 | 31.6 | 57.8 | 0 | 5620 |
| 2.0-max | Q8_0 | 31.1 | 52.0 | 34.3 | 0 | 13266 |
| omni-pico | Q8_0 | 21.3 | 42.3 | 52.8 | 0 | 1230 |
| omni-1.0-mini | Q8_0 | 32.1 | 44.8 | 32.8 | 0 | 5304 |
| omni-1.0-max | Q8_0 | 72.9 | 107.5 | 14.1 | 0 | 13114 |
Zero błędów wszędzie. VRAM równa się wartości z benchu, bo KV cache jest rezerwowany przy starcie.
Dwie uwagi do tej tabeli:
- W przeciwieństwie do benchu (gdzie pico ma lepsze
lat2idec/s) w tym teście 2.0-4.5B wygrywa z pico: 57.8 vs 52.8 dec/s, p50 18.1 vs 21.3 ms, p95 31.6 vs 42.3 ms. Możliwe, że to efekt hybrydowej architektury pico: według wpisu o 2.3.2 silnik dekoduje prompty takich modeli pojedynczo. To korelacja, nie zmierzona przyczyna. - p50 dla mini (9.3 ms) leży poniżej
lat1z benchu (11.3 ms), a 127 dec/s przy 32 klientach oznacza ok. 250 ms na decyzję (zakładam jedną decyzję na zapytanie). Te liczby nie mogą opisywać tej samej wielkości, więc p50/p95 w loadteście traktuję jako czas po stronie serwera (zakładam, że to poleusagez odpowiedzi), a nie opóźnienie widziane przez klienta. Do oceny przepustowości używamdec/s.
Wpływ liczby slotów llama.cpp przy basal-serve (--http-parallel)
Ustawienia llama.cpp: -c = 8192 x np, np od 1 do 32. np określa, ile zapytań na raz ma przyjąć llama.cpp server.
Domyślnie basal-serve ma --http-parallel 1. Otrzymujemy płaskie wyniki, co widać w tabelce poniżej.
| model | np | kontekst | p50 [ms] | p95 [ms] | dec/s | VRAM [MiB] |
|---|---|---|---|---|---|---|
| 2.0-mini | 1 | 8192 | 13.6 | 16.7 | 130.5 | 2030 |
| 2.0-mini | 2 | 16384 | 9.4 | 16.3 | 127.0 | 2166 |
| 2.0-mini | 4 | 32768 | 9.5 | 16.0 | 122.2 | 2438 |
| 2.0-mini | 8 | 65536 | 9.4 | 16.1 | 130.0 | 2996 |
| 2.0-mini | 16 | 131072 | 9.4 | 16.0 | 124.9 | 4148 |
| 2.0-mini | 32 | 262144 | 9.7 | 16.3 | 123.5 | 6452 |
| omni-pico | 1 | 8192 | 21.5 | 38.5 | 56.0 | 1146 |
| omni-pico | 2 | 16384 | 20.5 | 38.1 | 53.2 | 1224 |
| omni-pico | 4 | 32768 | 20.5 | 38.5 | 53.2 | 1396 |
| omni-pico | 8 | 65536 | 20.0 | 38.2 | 53.4 | 1742 |
| omni-pico | 16 | 131072 | 20.4 | 38.3 | 53.2 | 2432 |
| omni-pico | 32 | 262144 | 20.6 | 38.8 | 52.4 | 3812 |
Przepustowość jest płaska: więcej slotów nic nie daje, a VRAM rośnie tylko z preallokowanym KV cache. Powód: przy --http-parallel 1 basal-serve wysyła do backendu jedno zapytanie naraz, więc dodatkowe sloty stoją puste.
Po zmianie basal-serve na --http-parallel 32 podnoszenie liczby slotów w llama.cpp server zaczyna przynosić wymierne efekty. Moja hipoteza (nie pomiar): serve renderuje i parsuje kolejne zapytania, gdy sloty są zajęte, więc praca serve przestaje być wąskim gardłem.
| model | np | kontekst | p50 [ms] | p95 [ms] | dec/s | VRAM [MiB] |
|---|---|---|---|---|---|---|
| 2.0-mini | 1 | 8192 | 13.6 | 16.3 | 152.4 | 2030 |
| 2.0-mini | 2 | 16384 | 9.8 | 16.5 | 202.8 | 2166 |
| 2.0-mini | 4 | 32768 | 9.3 | 16.1 | 253.7 | 2440 |
| 2.0-mini | 8 | 65536 | 9.5 | 15.9 | 268.7 | 2996 |
| 2.0-mini | 16 | 131072 | 9.5 | 16.1 | 242.9 | 4148 |
| 2.0-mini | 32 | 262144 | 9.8 | 16.3 | 175.6 | 6452 |
| omni-pico | 1 | 8192 | 21.7 | 38.4 | 60.4 | 1146 |
| omni-pico | 2 | 16384 | 20.2 | 38.1 | 64.1 | 1224 |
| omni-pico | 4 | 32768 | 20.2 | 37.6 | 66.4 | 1396 |
| omni-pico | 8 | 65536 | 20.4 | 38.0 | 66.7 | 1742 |
| omni-pico | 16 | 131072 | 20.4 | 38.3 | 65.4 | 2434 |
| omni-pico | 32 | 262144 | 20.7 | 38.1 | 63.0 | 3814 |
Dla 2.0-mini optimum to np 4-8 (253.7-268.7 dec/s), potem przepustowość spada: przy np 32 jest tylko 175.6, co przypisuję narzutowi obsługi kolejki w serve (to hipoteza, nie pomiar). Pico osiąga szczyt przy np 8 (66.7) i od np 2 jest płaskie w granicach szumu.
W porównaniu z --http-parallel 1 te same konfiguracje są szybsze od 1.08x (pico np 1) do 2.08x (mini np 4), przy niezmienionych p50, p95 i VRAM. Najlepsza konfiguracja zmierzona na tej maszynie: 2.0-mini, np 8, hp 32, 268.7 dec/s, 2996 MiB VRAM.
Stany syntetyczne
basal-loadtest po HTTP z flagą --synthetic: syntetyczne elementy ze stanami (state) o zadanej długości w tokenach. --http-parallel 32, KV q8_0.
| model | stan (tokeny) | np | p50 [ms] | p95 [ms] | dec/s |
|---|---|---|---|---|---|
| 2.0-mini | 100 | 2 | 98.2 | 122.7 | 10.6 |
| 2.0-mini | 100 | 8 | 98.9 | 123.8 | 10.4 |
| 2.0-mini | 250 | 2 | 98.8 | 123.2 | 10.6 |
| 2.0-mini | 250 | 8 | 99.4 | 123.6 | 10.4 |
| 2.0-mini | 500 | 2 | 98.9 | 122.9 | 10.6 |
| 2.0-mini | 1500 | 2 | 98.2 | 123.1 | 10.6 |
| 2.0-mini | 1500 | 8 | 99.8 | 123.9 | 10.4 |
| omni-pico | 1500 | 2 | 85.5 | 108.8 | 15.4 |
| omni-pico | 1500 | 8 | 86.6 | 112.2 | 14.6 |
Przepustowość mini spada z 268.7 do ok. 10.5 dec/s (p50 ok. 98 ms zamiast 9.5 ms), ale jest taka sama dla stanów 100, 250, 500 i 1500 tokenów, a np 8 nie zmienia niczego względem np 2. To nie wygląda na koszt prefillu ani głębokości KV, tylko na stały koszt na zapytanie, po stronie basal-serve albo generatora obciążenia. Nie wyjaśniłem tego, więc z tej tabeli nie wyciągam wniosków o długich stanach.
Wnioski
Który model basal wypada najlepiej na karcie z 16 GB VRAM?
Cztery wykresy, zanim przejdę do rekomendacji. W motylkach lewe skrzydło to pierwsza wielkość z tytułu, prawe druga, słupki kreskowane to ścieżka natywna. Pamięć natywna (torch, GB) i llama.cpp (MiB) jest skalowana tylko poglądowo, bo to różne pomiary.
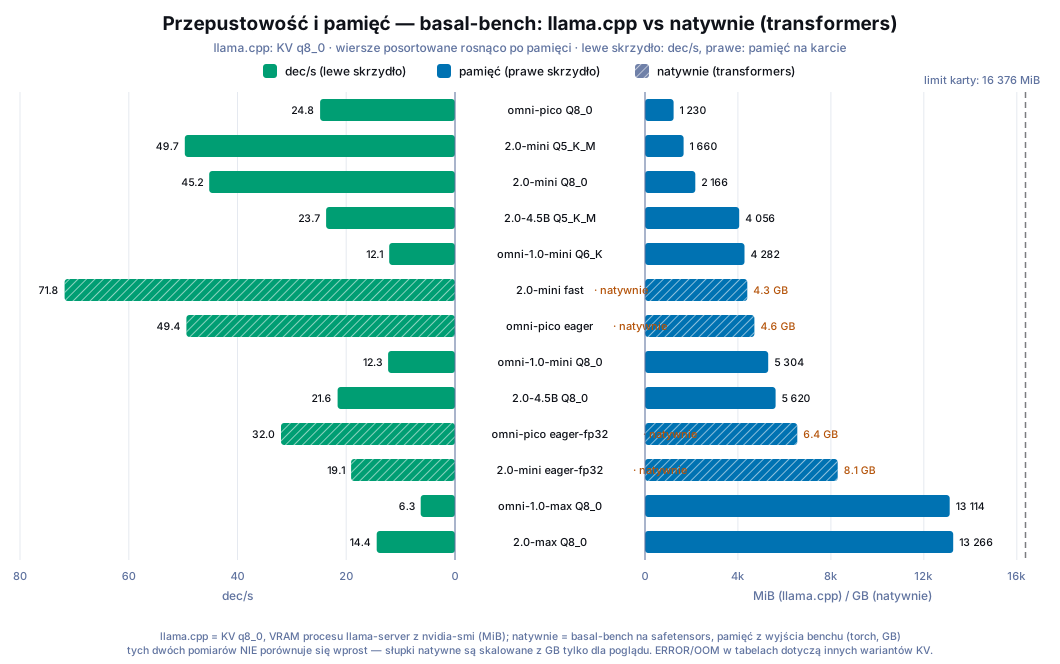
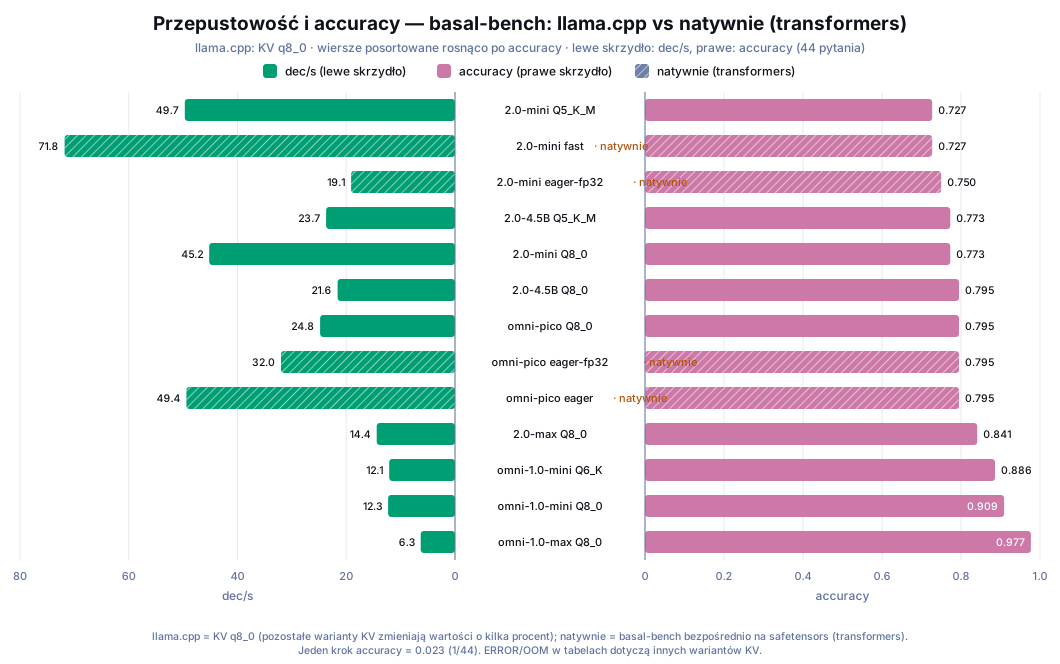
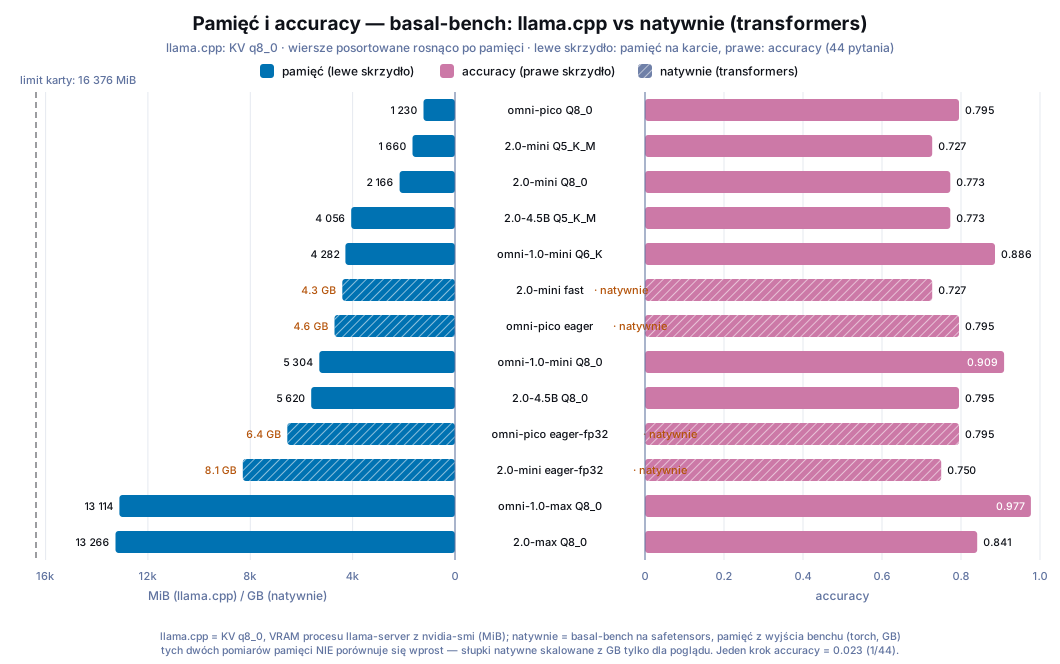
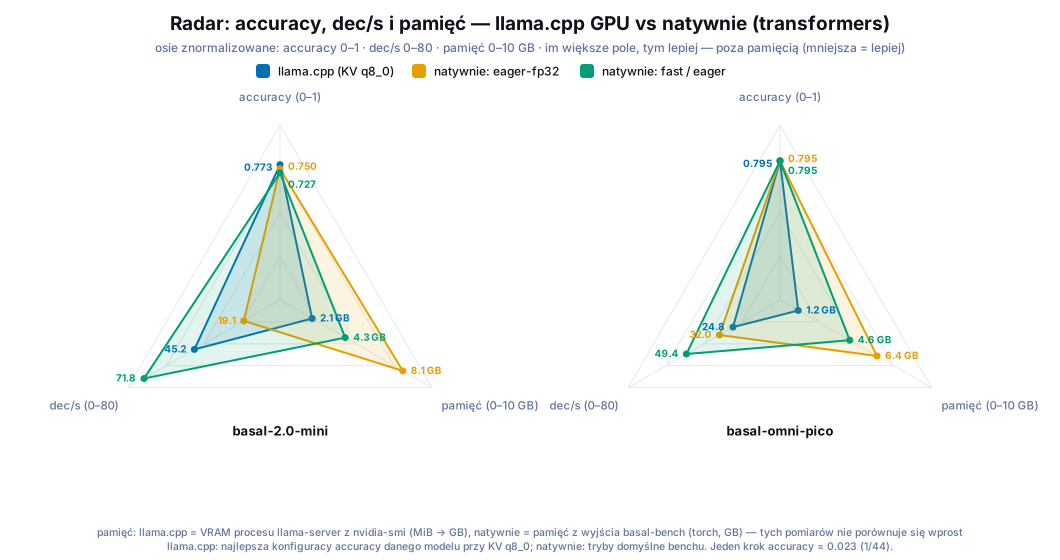
Domyślny wybór: omni-1.0-mini Q8_0
0.909 przy 5,1-5,3 GiB — drugi wynik accuracy w teście (po omni-max) za niecałą 1/3 karty, z zapasem na desktop i inne usługi. Koszt: lat2 ok. 62 ms (ok. 2,5x więcej niż pico) i 12 dec/s w benchu. Gdy trzeba odzyskać 1 GiB: Q6_K (4,1-4,3 GiB), bez straty latencji i z accuracy 0.886-0.909.
System One + System Two?
Gdy na tej samej karcie ma jeszcze działać model Systemu 2, wybór dyktują wolne GiB, nie accuracy. KV cache jest preallokowany przy starcie, więc oba procesy muszą się zmieścić na stałe. Z 16 376 MiB (ok. 16 GiB) karty zostaje: ok. 14,8 GiB przy omni-pico, ok. 13-14 GiB przy 2.0-mini, ok. 12 GiB przy omni-1.0-mini Q6_K — na model klasy 7-14B w Q4/Q5 (zwykle 8-10 GB wag plus kontekst) wystarcza. omni-1.0-max i 2.0-max (12,2-13,4 GiB) zostawiają 2,6-3,8 GiB — współdzielenie karty i “maksymalna jakość” wykluczają się nawzajem. Rozsądne pary: omni-1.0-mini Q6_K (0.886-0.909) + mniejszy System 2, albo pico (0.795) / 2.0-mini (0.773), jeśli System 2 ma być z tych nieco większych.
Liczy się tylko jakość
Maksymalna jakość: omni-1.0-max, ale tylko z KV q8_0 lub q4_0. Jedyny model z 0.977. q4_0 daje to samo accuracy co q8_0 przy 0,3 GiB mniej (304 MiB); f16 to 13,4 GiB i najgorsze p95 (184.6 ms) bez żadnego zysku. Koszt całkowity: 12,5-13,4 GiB (po desktopie zostaje niewiele) i lat2 123-150 ms — najwolniejszy w teście.
Najlepszy VRAM/Accuracy
Najlepszy stosunek kosztu do trafności: omni-pico. 0.795 przy 1,2-1,3 GiB i lat2 ok. 24 ms. 2.0-4.5B daje w benchu to samo accuracy, ale jest gorszy na każdej osi przy 4-6 GiB VRAM. Wygrywa z pico tylko przepustowością w teście HTTP przy --http-parallel 1 (57.8 vs 52.8 dec/s), a tę przewagę ma z nawiązką tańszy 2.0-mini (127 dec/s przy 2,1 GiB), więc nie widzę dla 4.5B roli na tej karcie.
Największa prędkość
Maksymalna przepustowość: 2.0-mini — accuracy 0.727-0.773 (w granicach remisu z pico i 4.5B), ale 268.7 dec/s z np 8 i --http-parallel 32; największy zysk dała konfiguracja serve, nie model. Do zadań masowych, nie jakościowych.
KV q8_0 jako domyślne ustawienie
Accuracy identyczne z f16 niemal wszędzie, przy 64-562 MiB oszczędności (przy większym -c proporcjonalnie więcej). q4_0 bezpieczne tylko dla modeli omni i 2.0-max; na 2.0-mini i 2.0-4.5B kosztuje 0.14-0.43 accuracy, a 2.0-max na f16 w ogóle nie wstaje — przy modelach ~13 GiB kwantyzacja KV to jedyny realny zapas.
Tryb natywny vs llama.cpp
Ścieżka natywna (transformers) w tym benchu nie wygrywa z llama.cpp na tej karcie. fast na mini ma wyższe dec/s (71.8 vs 45-53 na llama.cpp w benchu), ale lat1/lat2 są porównywalne lub gorsze (17.0 vs 12.7-15.5 ms), pamięć torch to 4,3 GB vs 2,1 GiB (pomiary nie do końca porównywalne), a accuracy bez zysku. omni-1.0-mini natywnie nie wstaje (15,9 GiB safetensors). Nie mierzyłem natywnie pod obciążeniem HTTP, więc nie rozstrzygam, jak wypada produkcyjnie.
WAŻNE Wszystkie wartości accuracy w tym wpisie pochodzą z basal-bench na wbudowanych w pakiet stanach i pytaniach: 44 elementy, więc każdy wynik to wielokrotność 1/44 (0.023). Różnice 0.773 vs 0.795 czy 0.909 vs 0.977 to jedna-dwie odpowiedzi.
Jeśli masz pytania, widzisz błąd w pomiarach albo chcesz porównać wyniki na własnym sprzęcie, napisz na X: @kskrzypinski.
Photo by Linus Belanger